Видео с ютуба Kernel Launch Overhead

CUDA Streams, Events and CUDA Graphs | How CUDA graph cut Kernel launch overhead?

Kernel Launch Overhead: Why Many Small Ops Are Slow — Practical PyTorch | 3.8

Параметризованный запуск графов CUDA в PyTorch: графы CUDA без лишних сложностей — Даниэль Гальве...

Why Your Multi-Petaflop GPU Spends 75.7% of Its Time Completely Idle!

Напишите своё первое ядро CUDA за 15 минут (потоки, блоки, сетка объяснены подробнее)

Оптимизированное ядро редукции: разбор | CUDA: редукция на уровне варпов и блоков

Where to Stop Fusing GPU Kernels: The Megakernel Dilemma

Why Faster GPU Code Often Means Launching Fewer Kernels

KernelAgent: аппаратная оптимизация GPU-ядер посредством... Каймин Чен, Джек Ку и Лора Ван

Краткий доклад: Комбинированные ядра: Оптимизация горизонтального слияния... Картик Паннер Сельва...

Offloading a System Task via OpenCL
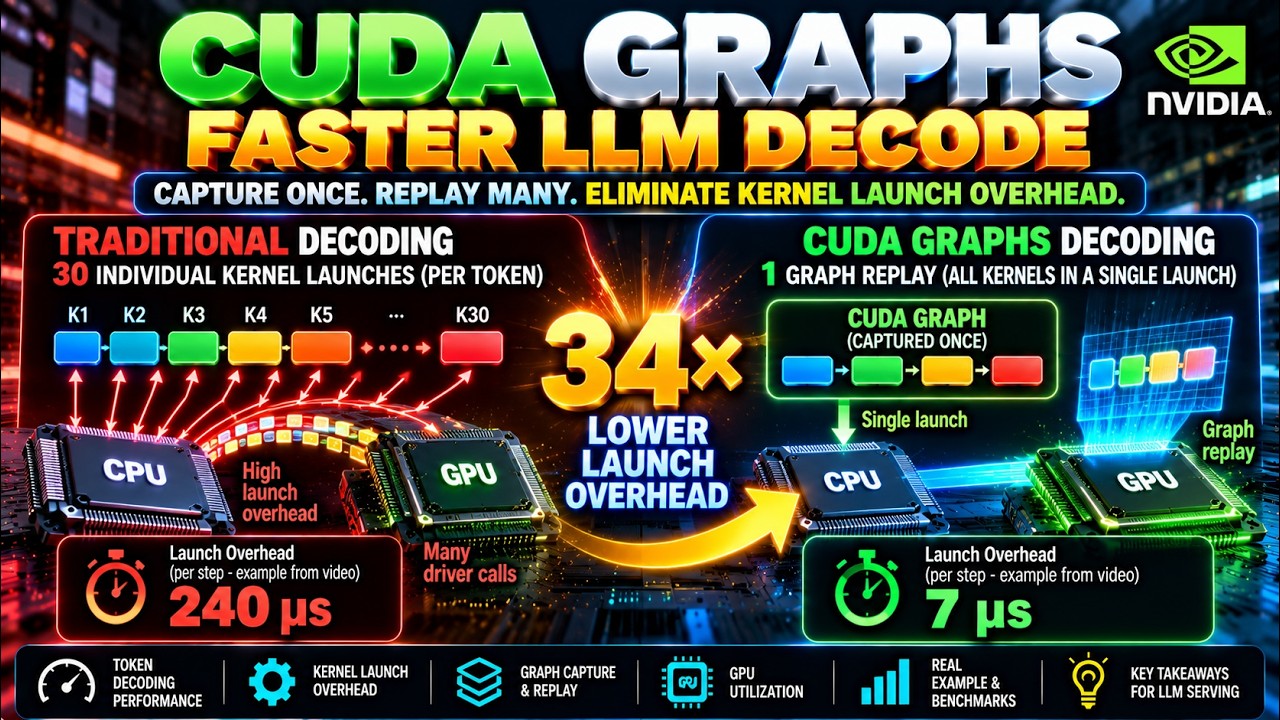
The GPU Isn't Slow, It's Waiting: How CUDA Graphs Fix LLM Decode Latency

What Actually is a CUDA Kernel?

18. Программирование GPU-ядер [HPC на Julia]

CUDA graphs explained: why the GPU waits on the CPU

Observing all kernel functions: how hard could it be? - DevConf.CZ 2024

Why One Token Launches Over a Thousand GPU Kernels